
Sieć działa stabilnie podczas normalnego działania, ale kilka urządzeń nie łączy się ponownie po restarcie całej lokalizacji. Jedną z możliwych przyczyn jest próg ochrony ustawiony poniżej dopuszczalnego poziomu rozruchu. Ustawienia kontroli burzy, które wydają się konserwatywne w przypadku nieaktywnej sieci, mogą stać się uciążliwe w momencie, gdy odzyskiwanie danych jest najważniejsze.
Storm Control ogranicza wybrany ruch zgodnie z klasyfikacją, pomiarami i regułami działania platformy. Ta sama wyświetlana wartość może oznaczać bardzo różne prędkości na różnych interfejsach lub urządzeniach. Zacznij od zrozumienia tych reguł, a następnie wykorzystaj obserwowany ruch aplikacji do wyboru i przetestowania polityki.
Określ dokładnie, co jest ograniczane
Sprawdź, czy ustawienie dotyczy transmisji rozgłoszeniowej, multicastu, nieznanego unicastu lub innej udokumentowanej kategorii. Znany unicast i nieznany unicast nie są terminami zamiennymi, a multicast może obejmować ruch niezbędny dla aplikacji.
Określ, czy kategorie są liczone osobno, czy razem, i gdzie odbywa się pomiar. Przeczytaj dokładną dokumentację modelu, zamiast zakładać, że znana etykieta menu innego dostawcy ma ten sam zakres.
Ciscoprzewodnik konfiguracji kontroli burzyIlustruje rolę klas ruchu, progów i mechanizmów tłumienia. Jego ustawienia i limity implementacji są specyficzne dla platformy, dlatego należy go traktować jako punkt odniesienia koncepcyjnego, a nie gotową konfigurację dla innego przełącznika.
Przed porównaniem ustawień przetłumacz jednostkę progową
Jeśli próg jest wyrażony jako procent przepustowości interfejsu, prędkość interfejsu zmienia swoje nominalne znaczenie. Jeden procent z 1 Gb/s to 10 Mb/s, a jeden procent ze 100 Mb/s to 1 Mb/s. Są to przykłady arytmetyczne; rzeczywista szczegółowość rozliczeń i egzekwowania przez sprzęt nadal wymaga potwierdzenia.
Próg liczby pakietów na sekundę mierzy inną wartość. Przy przykładowym 1000 pakietów na sekundę, pakiety 100-bajtowe odpowiadają za 0,8 Mb/s zliczonych bajtów, a pakiety 1000-bajtowe za 8 Mb/s. Narzut sieciowy i definicja zliczanej długości w przełączniku mogą zmienić tę zależność.
Ta różnica ma znaczenie, gdy porównuje się obciążenie sterowania małymi pakietami z większymi pakietami multimedialnymi. Ustawienie skopiowane z innego portu może narzucić zasadniczo inny limit praktyczny, nawet jeśli oba porty wyświetlają tę samą wartość.
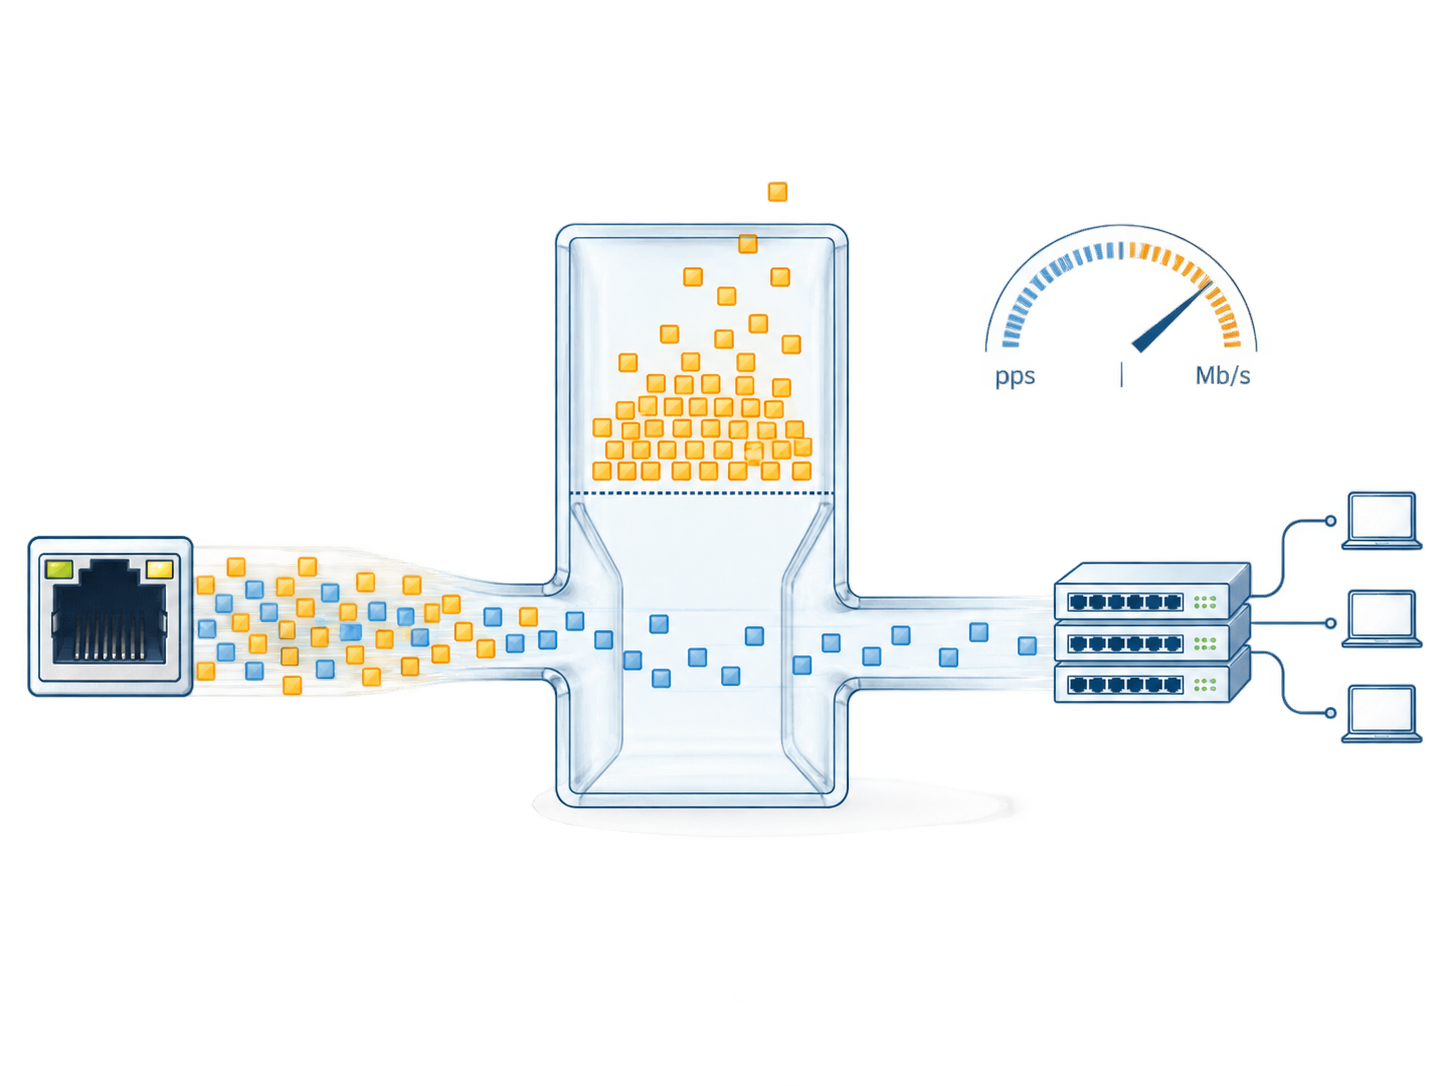
Średni ruch nie jest wystarczający, aby wybrać limit
Obserwuj sieć w stanach, które generują prawidłowe pakiety: uruchamianie, rozpoznawanie adresów, wykrywanie, połączenia multicastowe, zmiany topologii i ponowne łączenie aplikacji. Zidentyfikuj, które z tych zdarzeń należą do kontrolowanej klasy ruchu.
Użyj interwału pomiarowego, który może ujawnić istotny wzorzec. Długa średnia może złagodzić krótki impuls, który interwał wymuszania przełącznika traktuje inaczej. Uzyskaj informacje o interwale i zachowaniu progowym urządzenia, jeśli jest to udokumentowane, w tym o wszelkich dopuszczalnych impulsach lub zaokrągleniach.
Zachowaj powiązanie danych o ruchu z konfiguracją i obciążeniem. Baza z pięciu podłączonych urządzeń nie jest automatycznie odpowiednia po rozszerzeniu do pięćdziesięciu. Nowa wersja oprogramowania układowego lub tryb aplikacji mogą również zmienić sposób wykrywania i odzyskiwania.
Wybierz akcję tak ostrożnie jak próg
W zależności od implementacji, zdarzenie może wstrzymać wybrany ruch, wywołać alarm, wyłączyć port lub połączyć działania. Te rezultaty mają różne konsekwencje dla usług. Wyłączenie portu może wpłynąć na cały ruch na tym porcie, nawet jeśli wyzwalacz dotyczył jednej klasy.
Zdefiniuj, co powinno się stać po zdarzeniu. Czy przekierowanie zostanie przywrócone, gdy przepustowość spadnie poniżej udokumentowanego poziomu? Czy istnieje oddzielny próg spadku? Czy operator musi przywrócić wyłączony port? Jeśli automatyczne odzyskiwanie jest włączone, co zapobiega wielokrotnemu cyklicznemu nawiązywaniu połączenia z powodu trwałego błędu?
Przyjęta polityka powinna odpowiadać na te pytania pod względem operacyjnym. Alarm, którego nikt nie odbierze, nie zapewnia takiej samej ochrony, jak zdarzenie monitorowane z procedurą reagowania. Polityka wyłączania bez dostępnej metody odzyskiwania może wydłużyć przerwę, którą miała powstrzymać.
Przejrzyj porty według ich ról
| Rola portu | Ruch do zrozumienia | Obawy dotyczące przeglądu progów |
|---|---|---|
| Bezpośredni punkt końcowy | Jego zwykłe, startowe i awaryjne zachowanie | Wąska linia bazowa może nie uwzględniać prawidłowych serii odzyskiwania |
| Przełącznik dostępu downstream | Agregowany ruch z kilku punktów końcowych | Skopiowany próg punktu końcowego może być zbyt restrykcyjny |
| Ścieżka odbiornika multicastowego | Wymagane grupy medialne i wymiany kontrolne | Niezbędny multicast musi pozostać użyteczny |
| Nadmiarowe łącze w górę | Ruch przed i po zmianie trasy | Ocalała ścieżka może unieść większy ładunek |
| Tymczasowe połączenie konserwacyjne | Oczekiwane narzędzia i działania odkrywcze | Praca krótkoterminowa powinna być zgodna z zatwierdzoną polityką portu |
Unikaj jednej uniwersalnej wartości dla każdego interfejsu, chyba że przemawiają za tym dowody projektowe. Spójność ról portów jest bardziej użyteczna niż jednolitość numeryczna.
Zweryfikuj zarówno przypadki zdrowe, jak i nieprawidłowe
W teście kontrolowanym przeprowadź prawidłowe obciążenie poprzez uruchomienie i ponowne połączenie. Upewnij się, że wymagane usługi działają poprawnie bez nieoczekiwanego wstrzymania lub wyłączenia. Obserwuj odpowiednie liczniki i zdarzenia, a nie tylko to, czy łącze pozostaje aktywne.
Następnie przeprowadź zatwierdzoną analizę nietypowego ruchu w odizolowanym lub odpowiednio kontrolowanym środowisku. Zweryfikuj zamierzone działanie i jego wpływ na niezakłócone usługi. Zapisz klasę ruchu, wzorzec natężenia ruchu, czas i wynik odzyskiwania.
Nie generuj burzy w sieci produkcyjnej tylko po to, aby sprawdzić, czy pole wyboru działa. Środowisko testowe i metoda wstrzykiwania powinny być zgodne z zatwierdzonym procesem w danej lokalizacji. Reprezentatywny pilot może ustalić zachowanie przed szerokim wdrożeniem polityki.
Jeśli podczas normalnej pracy wystąpi zdarzenie progowe, przed podniesieniem limitu należy zbadać jego źródło i wzorzec. Przyczyną może być legalne rozszerzenie, błędnie skonfigurowany punkt końcowy lub niezamierzona pętla warstwy 2. W tych przypadkach konieczne są inne rozwiązania.
Utrzymuj zapobieganie pętlom i zarządzanie członkostwem
Kontrola burz to ochrona wspomagająca, a nie zastępująca topologię bez pętli. Pętla może nadal powodować zakłócenia, nawet gdy wybrany ruch zostanie zablokowany. Należy sprawdzić okablowanie bazowe oraz konstrukcję drzewa rozpinającego lub pierścienia, gdy dowody na to wskazują.
Podobnie, niepożądana dystrybucja multicast może wymagać sprawdzenia członkostwa i zapytania. Zaostrzenie progu multicast może zamaskować zalewanie, a jednocześnie uszkodzić odbiorniki potrzebujące strumienia. Należy poprawić projekt przekierowania, a następnie zweryfikować politykę przepustowości w odniesieniu do wygenerowanego ruchu.
Celem jest ograniczenie nieprawidłowego zachowania przy jednoczesnym zachowaniu akceptowanego działania aplikacji. Wymaga to zarówno solidnej konstrukcji sieci, jak i odpowiednio przetestowanej reakcji ochronnej.
Udokumentuj powód każdej wdrożonej wartości
DlaWybór przełączników zarządzanych TODAHIKA, poproś o obsługiwane klasy ruchu, jednostki progowe, zachowanie pomiaru, widoczność zdarzeń i kontrolę odzyskiwania dla konkretnego modelu. Dołącz role portów i krytyczne wymagania uruchomieniowe do zapytania.
Zachowaj wybrane ustawienia wraz z obserwacjami bazowymi i wynikami testów. Określ, jaka zmiana powoduje weryfikację: więcej punktów końcowych, nowa usługa multicast, zmiana prędkości łącza w górę czy zmieniona sekwencja odzyskiwania. Ten zapis pozwoli kolejnemu inżynierowi na celowe dostosowanie polityki, zamiast dziedziczyć niewyjaśnioną wartość, która może już nie pasować do sieci.
Czas publikacji: 01.09.2026


